我用 DeepDeck Bench 比较几个模型完成浏览器任务的成本、耗时,以及开启 WebMCP 后的步骤变化。MiMo 的工具调用错误较多,我进一步检查了调用记录,想确认问题出在模型决策还是工具接口。
我保持模型不变,修改了 DeepDeck 的工具调用接口,再复测原来错误较多的用例。MiMo 在这组题上的耗时明显下降,Luna 的总耗时基本持平。下面是问题定位、修改和复测的过程。
初测:MiMo 成本低,但耗时较长
DeepDeck 是基于 DeepSeek Harness 构建的桌面客户端。Harness 提供模型执行任务所需的环境,包括可见信息、工具接口、错误反馈和结果检查。
DeepDeck Bench 当时覆盖 8 个本地网站、49 道浏览器任务。每个模型都分别跑开启和关闭 WebMCP 的两组。WebMCP 让网站把“查询订单”“筛选目录”这类操作直接提供成工具;关闭时,Agent 需要通过其他浏览器操作完成任务。两组对照用于评估 WebMCP 对任务完成情况和资源用量的影响。
初测中,MiMo V2.6 Flash 的成本低,但耗时较长,开启 WebMCP 后节省的步骤也少于预期。我最初认为它使用工具不够高效,但还需要从调用记录中确认原因。
我按工具发现、工具选择、参数填写和结果确认几个阶段检查记录,寻找耗时和错误集中的步骤。
调用记录:模型混淆了目录标识和工具版本
调用记录显示,MiMo 会发现并调用 WebMCP 工具。其中一类重复错误是把工具目录的 digest 当成某个工具的 revision。前者是整份目录的缓存标识,后者是工具版本,两者不能混用。
旧接口要求模型提供业务参数,同时填写工具名、frameId、documentId,以及适用时的 revision。即使选对了工具,定位信息填写错误也会导致调用被拒绝。模型随后重新发现工具、再次尝试,增加了耗时和 token 用量。
这类错误说明,接口设计也影响了模型表现。工具定位信息可以由程序保存和校验,旧接口却要求模型每次填写。Luna 较少填错,但这项要求对完成业务任务并无必要。
修改:不用模型重复填写页面和版本编号
我让 DeepDeck 在列出工具时,为每个工具生成一个短编号,叫 toolRef。同时,DeepDeck 保存这个编号对应的页面、页面内区域和工具版本。模型从清单中选择工具后,只需提供工具编号和查询内容。原来要由模型抄写的定位信息,改由 DeepDeck 自动取出并检查。
同一个任务:用订单号和邮箱查询订单状态
以前:模型填写所有信息
- 要用什么工具:查询订单
- 要查什么:订单号、邮箱
- 工具在哪里:页面编号、页面内区域编号
- 工具是什么版本:版本编号(如有)
即使选对了工具,页面或版本编号填错,调用也会被拒绝。模型需要重新查看工具清单,再试一次。
现在:模型少填定位信息
- 要用什么工具:从清单选“查询订单”,使用它的工具编号
- 要查什么:仍然填写订单号、邮箱
DeepDeck 根据工具编号取出已保存的页面、区域和版本信息,检查是否有效,再执行调用。模型不用再抄这些字段。
模型仍然负责选择工具和填写业务参数。工具定位信息由 DeepDeck 管理,不再要求模型重复填写。
页面或工具变化后,旧引用失效,调用会被拒绝。旧格式的调用仍保留严格的身份校验。
我还把错误分成两类:“没有派发操作”和“操作可能已经执行,但结果未知”。前一种可以重新发现工具;后一种要先检查业务状态。例如提交订单后页面跳转了,不能因为没拿到返回值,就自动再提交一次。
这些修改放在 DeepDeck 的 browser 插件里,没有直接改上游 Harness 源码。单元测试和真实 Electron 验证先确认了调用、导航失效和工具版本替换的行为,再做模型复测。
复测:两个模型、六道题,每题三次
这轮没有重跑全部 49 题。我挑了 6 个 WebMCP 调用错误较多的用例:权限边界、目录筛选、服务查询、课程报名、活动地点和订单查询。MiMo、Luna 各题各跑 3 次,共 36 次正式运行。
这些题在旧版里最终也通过了,中间有工具调用错误。因此,本轮比较的是调用错误、执行轮次、耗时和费用,不能据此声称任务成功率提高。
正式对照核对了题库、模型配置、上下文窗口、最大输出配置,以及可用工具名称集合。计时使用 Agent 执行时间,不把网站启动、重置和评分算进去。
旧基线每题只有一次,新版每题三次,而且不是同一时间随机交替运行。这种历史对照无法排除运行时间和模型输出波动的影响,不能把所有差异都归因于代码修改。
结果:MiMo 耗时下降,Luna 基本持平
36 次正式运行全部通过。下面的时间、轮次和费用,都是完成这 6 题的一组总量:旧版是一轮,新版是三轮的平均。WebMCP 错误率则按各组全部工具调用计算,不是任务失败率。
| 指标 | MiMo V2.6 Flash | GPT-5.6 Luna |
|---|---|---|
| WebMCP 调用错误率 | 75.0% → 27.5% | 38.9% → 21.6% |
| 整组耗时(分钟) | 20.04 → 5.75 | 3.07 → 3.02 |
| 整组执行轮次 | 108 → 60.3 | 46 → 41.7 |
| 整组估算费用(USD) | $0.05645 → $0.02633 | $0.04017 → $0.03624 |
MiMo 的总耗时从 20.04 分钟降至 5.75 分钟,执行轮次从 108 降至 60.3,估算费用下降约 53%。Luna 的工具错误也减少了,但总耗时几乎没变。
一个具体例子是查询 Yoga Class 是否存在。MiMo 旧版花了 150.5 秒,有 6 次 WebMCP 调用错误;新版三次复测都没有这类错误,平均 14.0 秒完成。
MiMo 旧订单题有一次接近 590 秒的慢运行,放大了整体耗时差异。去掉这题,其余 5 题的总耗时仍从 612.5 秒降到平均 304.8 秒,约减少一半,但仍受旧基线只有一次的限制。
退步用例和剩余错误
权限边界题中,MiMo 的平均执行轮次从 25 增至 26.7,费用也增加了;Luna 在这题上从 24.5 秒变成平均 55.5 秒。Luna 的课程报名题同样变慢。这次修改没有解决模型反复探索、未及时停止的问题。
两模型仍有 14 次调用使用了过期引用,另有 8 次在操作中遇到路由变化,无法直接确认结果。后续需要改进导航后的工具发现,以及页面跳转后的业务状态确认。
对于课程和订单题,我还检查了工具返回的业务证据,确认报名和首课访问实际发生,以及注册得到的订单号确实用同一个邮箱查询过。完成情况以这些记录为依据。
缓存计费与异常运行
费用按实际未缓存输入、缓存输入、输出,以及适用的缓存写入分别计算,统一使用原报告的美元单价。Luna 这里是 API 等价估算,不是 ChatGPT 订阅的实际增量账单。缺失用量不能直接当作零。
这次 MiMo 的输入缓存命中比例从 92.54% 降至 90.50%,Luna 从 76.19% 到 76.07%。新版的整体缓存命中比例没有提高。不过,重复运行仍可能改变服务端缓存,费用差异不能全部归因于代码修改。
过程中也有需要排除的运行。MiMo 最初 9 次预检没有匹配旧配置,单独归档后重新跑正式组;Luna 的 3 次订单题遇到评分端凭据过期,原始失败保留,修复评分环境后整组三次重跑,而不是挑一个成功结果。
正式比较用了 36 次运行,实际记录了 48 次。被排除的运行同样消耗了资源,因此也计入账本:本次所有已记录运行的 API 等价估算合计约 $0.244。
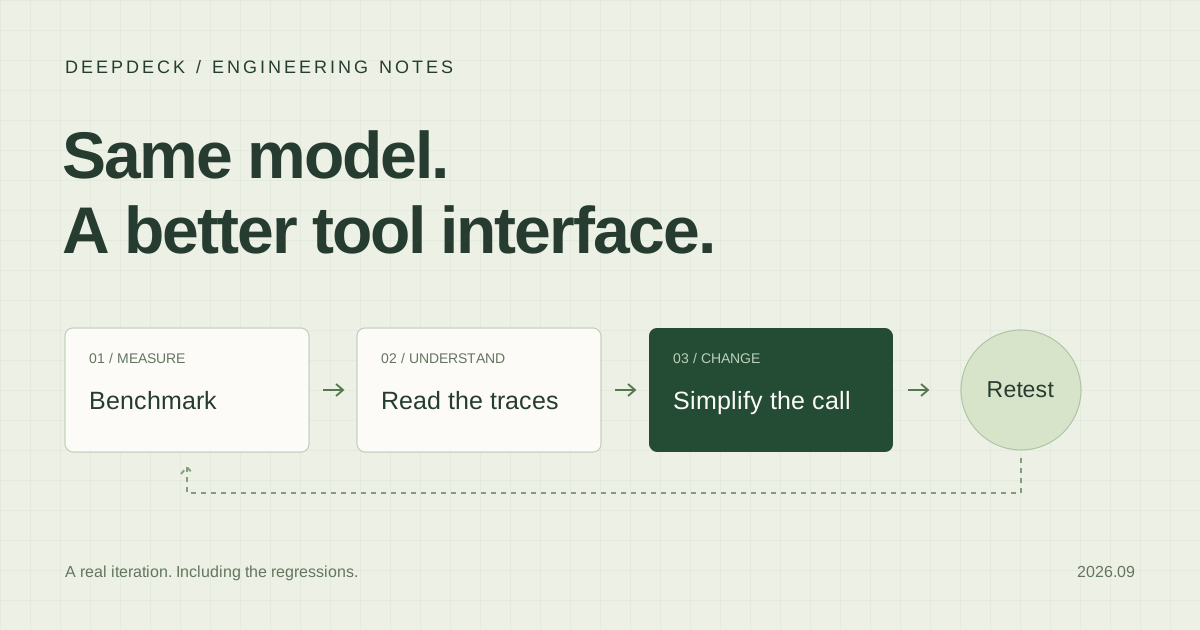
后续迭代流程
这次评测帮助我定位了反复发生的参数错误,并通过复测检查接口修改的效果。
后续迭代按以下步骤进行:
- 先保留旧版本、题库和运行配置,让下一次还有可比较的基线。
- 从耗时、成本和失败记录中选择问题,再检查对应的调用过程。
- 围绕一个明确原因修改接口或执行流程,先验证程序行为,再让模型重跑。
- 同时报告改善、退步和环境异常;把中间调用错误与最终任务失败分开。
- 用同样的任务和计费口径检查结果,再决定是否扩大到全量回归。
保留旧 Harness 作为对照基线
修复合入 main 前,我把旧版本保存到了 deepdeck-bench 分支。这样以后继续比较模型时,可以选择相同的 Harness;如果要评估 Harness 本身的进步,也可以明确地比较新旧版本。
如果模型和 Harness 同时变化,就无法区分两者对结果的影响。除代码版本外,题库、配置、运行条件和费用口径也需要记录。
这次修复已合入 main。复测支持它在这组选定用例上减少调用错误、降低 MiMo 执行成本;全题库表现还需要进一步验证。
OPEN RECORD